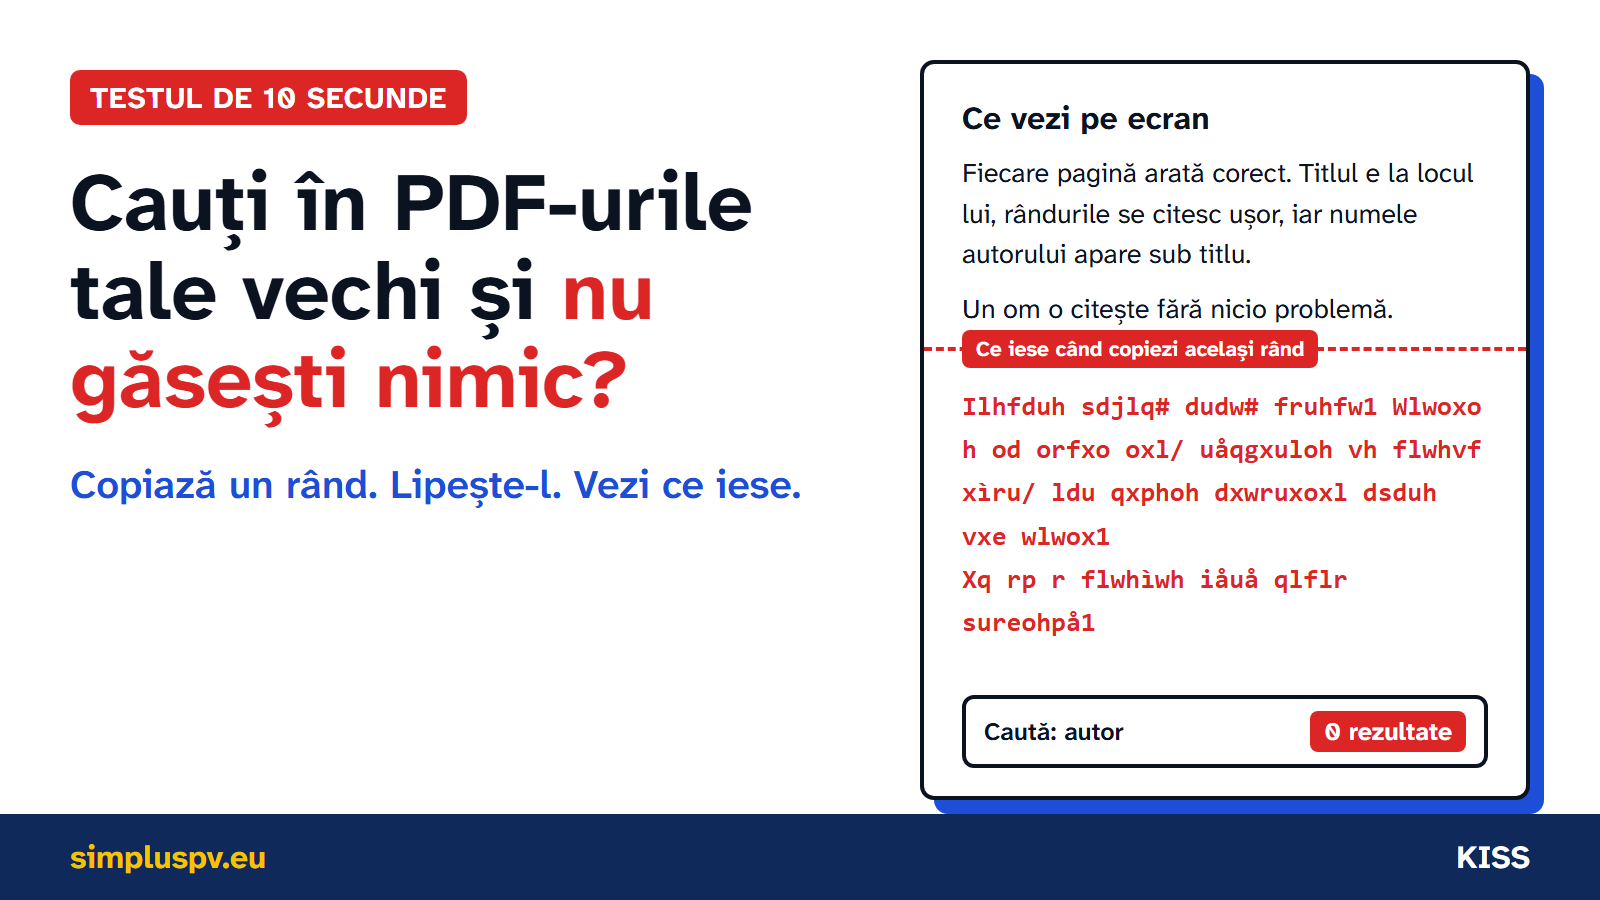
Un PDF în care nu poți căuta arată corect pe ecran, dar nu conține text pe care un calculator să-l poată citi. Afli în zece secunde dacă ai așa ceva: selectezi un rând din document, îl copiezi și îl lipești într-un document nou. Dacă apar litere amestecate sau nu se poate selecta nimic, în PDF-ul acela nu găsește nimic nici Ctrl+F, nici căutarea de pe site-ul tău, iar Google nu are text de citit în el.
Pe scurt:
- Un PDF poate arăta corect pe ecran fără să conțină niciun cuvânt pe care un calculator să-l poată citi.
- Testul durează zece secunde: copiezi un rând din PDF și îl lipești într-un document nou.
- Reparația se numește recunoaștere optică a textului (OCR) și nu schimbă aspectul paginilor.
- Într-o arhivă de 1042 de PDF-uri pe care am testat-o, 320 de fișiere erau în situația aceasta.
Cum afli dacă ai un PDF în care nu poți căuta?
- Deschide un PDF mai vechi din arhiva ta.
- Selectează un rând de text și copiază-l.
- Lipește-l într-un document nou.
| Ce vezi după lipire | Ce înseamnă |
|---|---|
| Rândul apare corect | PDF-ul are text. Se poate căuta în el. |
| Litere amestecate și semne fără sens | Literele sunt păstrate ca desene. Căutarea nu găsește nimic. |
| Nu poți selecta niciun rând | Pagina e o fotografie: documentul a fost scanat. |
Testul spune ceva despre un singur fișier. Pentru o arhivă întreagă, aceeași verificare se face automat, pe toate fișierele deodată.
De ce arată bine pe ecran, dacă nu are text?
Sunt două situații.
Prima: documentul a fost scanat. Fiecare pagină e o fotografie, iar într-o fotografie nu există litere, doar puncte de culoare.
A doua e mai greu de bănuit. PDF-ul a fost făcut din text, dar cu un program vechi de conversie, care a păstrat fiecare literă ca pe un desen, fără legătura cu caracterul ei real. Un om citește pagina fără nicio problemă. Un calculator vede doar desene.
Cât de des se întâmplă? Un caz din octombrie
În octombrie am lucrat cu editorul unei reviste care apare de peste douăzeci de ani. Copiase un paragraf dintr-un articol din arhivă și primise un șir de semne.
Voia un singur lucru: cine caută un autor sau o temă să ajungă la articol.
Problema nu era la site și nici la server. PDF-urile vechi fuseseră refăcute, în august 2017, cu un program depășit.
Am testat toate cele 1042 de PDF-uri ale revistei. 320 nu aveau text care să poată fi citit: 3727 de pagini la care nu ajungea nicio căutare.
Cum se repară un PDF fără text?
Prin recunoaștere optică a textului (OCR, din engleză: optical character recognition). Un program citește imaginea fiecărei pagini și adaugă peste ea textul pe care îl recunoaște.
- Imaginea originală a paginii rămâne neschimbată.
- Peste ea intră un strat de text invizibil, în limba română, cu diacritice.
- Fișierele își păstrează numele, deci linkurile existente rămân valabile.
- Originalele se păstrează separat, neatinse.
La cele 320 de fișiere, reparația mi-a luat o oră și jumătate. Fișierele au ieșit mai mari: în medie, de la 1 MB la 2–3 MB.
A mai durat o oră până când site-ul revistei a primit o căutare care citește în interiorul celor 932 de articole din arhivă.
Căutarea a mai făcut un lucru: a scos la iveală încă două PDF-uri cu text stricat, care nu intraseră în lotul reparat. O arhivă se verifică cel mai bine căutând în ea.
Ce nu face reparația
- Nu e o transcriere verificată cuvânt cu cuvânt. La nume proprii, la citate în alte limbi și la notele de subsol rămân mici greșeli de recunoaștere.
- Nu aduce înapoi fișierele care lipsesc. Un link către un PDF care nu mai există rămâne rupt.
- Nu îți urcă paginile în Google. Face doar posibil ca textul să fie citit.
Pentru căutare și pentru copiere, rezultatul e foarte bun. Pentru republicare, textul trebuie recitit de un om.
Ce poți face cu o arhivă în care se poate căuta?
Dacă ai cursuri, cărți, contracte sau rapoarte adunate în ani de muncă, textul lor devine material de lucru. Găsești pe loc unde ai scris despre un subiect. Poți pune o căutare pe site-ul tău. Iar un asistent AI poate lucra pe materialele tale, nu pe generalități.
Dacă ții cursuri, am arătat cum dintr-o singură înregistrare ies cinci lucruri. Dacă vrei să știi cum te găsesc clienții care nu mai caută în Google, am scris despre ce se întâmplă când clientul tău întreabă AI-ul.
Vrei să repari arhiva ta?
Ce dispare din munca ta: căutatul fișier cu fișier.
O facem împreună, pe fișierele tale, în ședințe de lucru 1-la-1. Testăm arhiva, reparăm ce e stricat și pleci știind să repeți pașii pentru fișierele noi.
Lucrez pe pachete de 10 ore: 1740 lei, de folosit în 3 luni de la prima ședință. Detaliile sunt pe pagina de mentorat.
Sunt inginer și lucrez cu sisteme de 30 de ani. Cazul de mai sus e real, din octombrie 2026, iar limitele lui sunt scrise mai sus.
Întrebări frecvente
De ce nu pot copia textul dintr-un PDF?
Fiindcă PDF-ul nu conține text. Fie e un document scanat, în care fiecare pagină e o fotografie, fie a fost făcut cu un program vechi, care a păstrat literele ca desene. În ambele cazuri, pe ecran pagina arată corect.
Ce înseamnă OCR?
Recunoaștere optică a textului. Un program citește imaginea unei pagini și scrie textul pe care îl recunoaște, ca strat invizibil peste imagine. După aceea, în document se poate căuta și din el se poate copia.
Se schimbă aspectul documentului după OCR?
Nu. Imaginea paginii rămâne cea originală. Se schimbă mărimea fișierului: în cazul descris aici, a crescut în medie de la 1 MB la 2–3 MB.
Poate un asistent AI să citească un PDF scanat?
Unii asistenți pot citi imaginea unei pagini pe care le-o dai, câte un document pe rând. O căutare într-o arhivă întreagă are nevoie ca textul să existe în fișiere.
Pot face singur reparația?
Da. Programele de recunoaștere a textului sunt gratuite. Eu am folosit Tesseract, care e open source, cu modelul pentru limba română. Partea care cere atenție e alta: să afli care fișiere au nevoie de reparație și să verifici rezultatul.